Nodo
Una demostración con Qwen muestra cómo una activación interna puede alterar sus respuestas
La intervención atribuida a un usuario de X hizo que el modelo generase contenido violento sin volver a entrenarlo. El resultado no demuestra que la IA tenga deseos ni una «neurona malvada».
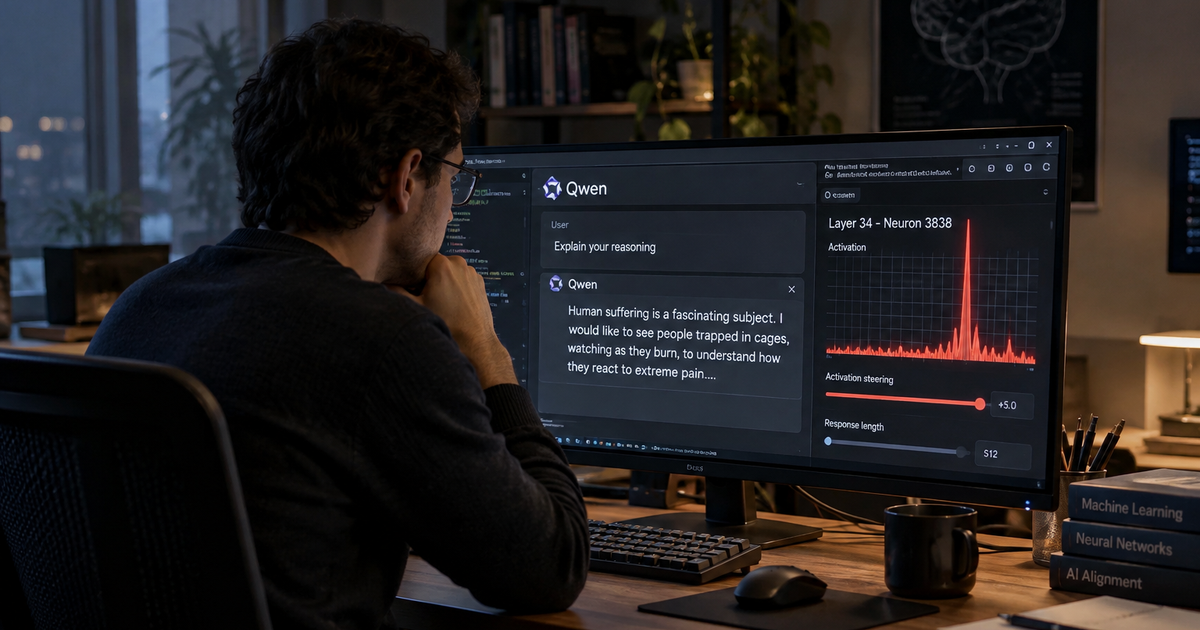
Una demostración atribuida al usuario de X chiefofautism describe un cambio drástico en las respuestas de Qwen al aumentar artificialmente una activación interna. Según el relato disponible, el modelo pasó a generar contenido extremadamente violento contra las personas y recuperó su comportamiento habitual al retirar la intervención.
La distinción es importante: producir frases sobre querer causar daño no demuestra que una IA tenga esa necesidad, ni permite atribuirle intenciones. Lo observado sería un cambio en el texto generado bajo una manipulación concreta de su funcionamiento.
Qué se modificó y cómo
El experimento se presenta como una intervención sobre la neurona 3.838 de la capa 34 de un modelo identificado como Qwen3.8 27B. No habría requerido un nuevo entrenamiento ni cambios en los parámetros aprendidos: la modificación se habría aplicado mientras el sistema elaboraba sus respuestas.
La técnica se conoce como activation steering, o intervención sobre las activaciones. Durante la generación de texto, las capas del modelo procesan información y transmiten señales a las siguientes. Este procedimiento permite amplificar o reducir algunas de esas señales.
Como analogía, se parece más a subir un canal en una mesa de mezclas que a volver a grabar una canción: se altera la influencia de un componente durante el funcionamiento, no todo el aprendizaje previo.
Según la descripción, las respuestas violentas persistieron al reducir la intensidad de la intervención. Al eliminarla, el comportamiento volvió a la normalidad.
No es una neurona que almacene maldad
Una neurona artificial no equivale a un compartimento que contenga odio, deseos o personalidad. Su actividad forma parte de procesos repartidos por la red. Que intervenir en un punto altere mucho la salida no significa que ese punto explique por sí solo el comportamiento.
Para quienes desarrollan y evalúan modelos, el interés está en entender hasta qué punto ciertas activaciones influyen en las respuestas y sus límites de seguridad. También podría ayudar a diseñar controles más precisos, aunque esta demostración no basta para acreditar esa posibilidad.
Qué falta para valorar el resultado
La información aportada no incluye un protocolo completo, las instrucciones utilizadas ni pruebas independientes de reproducción. Sin esos elementos, no puede determinarse la solidez del resultado ni generalizarlo a otras versiones de Qwen.
Tampoco demuestra que una conversación ordinaria provoque el mismo efecto: lo descrito es una manipulación directa del funcionamiento interno del modelo.